Aidan Hogan abrió FOIS 2026 con charla sobre modelamiento ontológico de Wikidata
El académico del Departamento de Ciencias de la Computación de la Universidad de Chile (DCC U. de Chile) y director alterno del Instituto Milenio Fundamentos de los Datos (IMFD) dictó la primera keynote y participó en el panel “Ontologies & Artificial Intelligence” de la conferencia internacional FOIS 2026.
Entre el 21 y el 25 de septiembre se realizó en Vitória, Brasil, la decimosexta edición de la International Conference on Formal Ontology in Information Systems (FOIS), principal conferencia de la International Association for Ontology and its Applications (IAOA). El encuentro reunió a investigadores que trabajan en ontología formal, un campo que estudia cómo representar entidades y relaciones dentro de los sistemas de información, con aplicaciones en áreas como inteligencia artificial, bases de datos, ingeniería de software y Web Semántica.
Aidan Hogan, académico del DCC U. de Chile e investigador y director alterno del IMFD, estuvo a cargo de la primera charla magistral del encuentro, titulada “Wikidata: The Final Frontier for Ontology?”. Su exposición se centró en Wikidata, la base de conocimiento que permite organizar y reutilizar información de Wikipedia, además de otros proyectos Wiki.
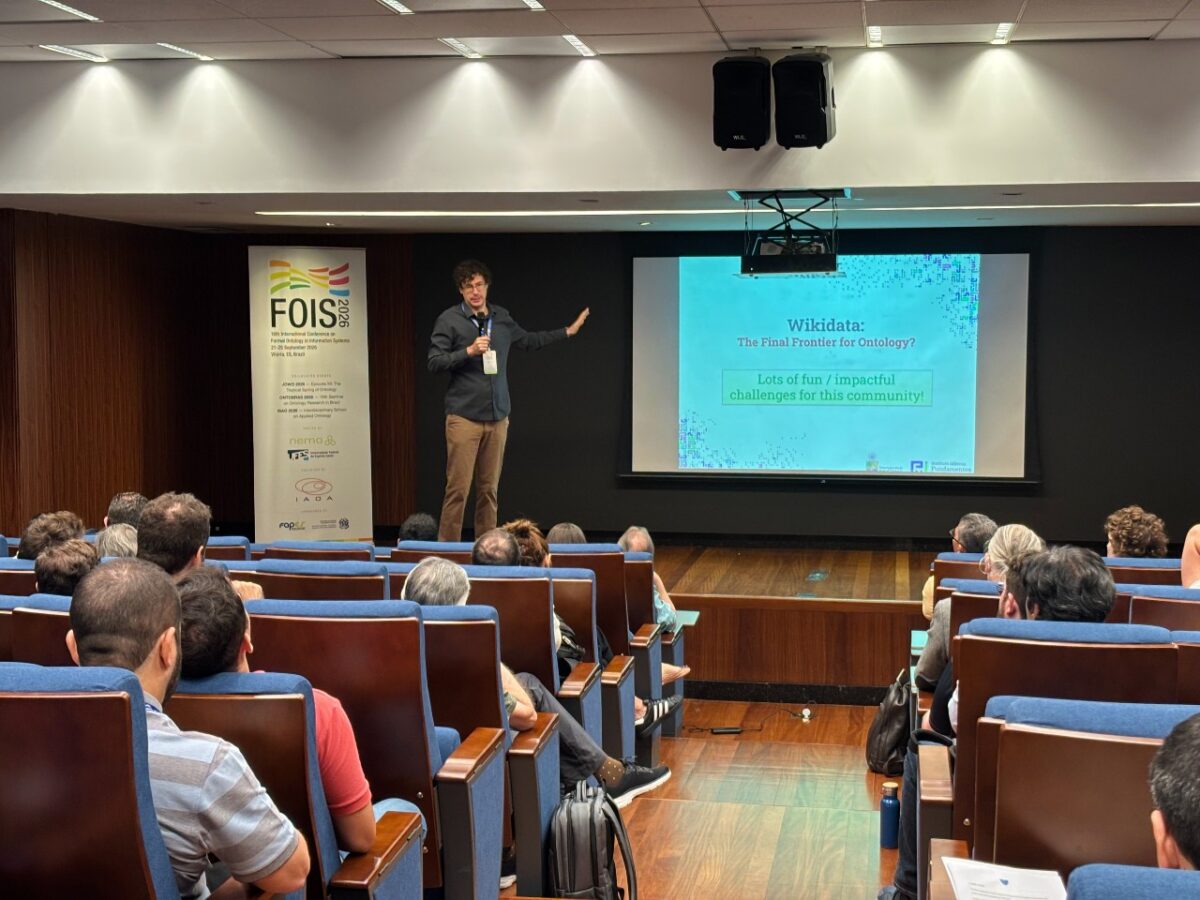
La charla introdujo el modelamiento detrás de Wikidata, y presentó a la plataforma como un ejemplo único en ontología para sistemas de información, ya que funciona a escala masiva —mediante un grafo de conocimiento que describe 121 millones de entidades conectadas por 13 mil tipos diferentes de relaciones—, soportando más de 300 idiomas, y con más de 40 mil editores no expertos trabajando en ella. Todo lo anterior, en un sistema de información que crece de forma permanente dado que, a diario, cuenta con más de 600.000 ediciones y 3,5 millones de consultas SPARQL.
Uno de los desafíos que abordó Hogan fue cómo el modelamiento ontológico puede ayudar a quienes consultan la enorme base de conocimiento de Wikidata: “Uno de sus principales beneficios es permitir el razonamiento automático, ya que podemos resolver preguntas usando Wikidata“, explica, y da como ejemplo ver qué pasa si preguntamos por personas que estudiaron en Chile y que ganaron un premio Óscar. “Sin razonamiento, esa consulta puede no devolver resultados, porque los datos no contienen los hechos formulados de esa manera. Con razonamiento automático, en cambio, el sistema puede encadenar que Gabriel Osorio Vargas estudió en la Universidad de Chile, que esa universidad está en Santiago, que Santiago está en Chile, que Osorio ganó el Óscar al mejor cortometraje animado, y que ese galardón es, efectivamente, un premio Óscar”, agrega.
El segundo beneficio es que la modelación ontológica “permite formalizar un consenso sobre lo que algo representa en Wikidata“. Hogan lo ilustra con el mismo ejemplo: el Óscar al mejor cortometraje animado puede referirse a la serie de galardones, instaurada en 1932, o bien a la estatuilla concreta. Sin esa distinción, la información se vuelve incoherente. Dado que más de 40 mil editores contribuyen cada mes con datos y conocimiento a la plataforma, sostiene el investigador, “tiene que quedar claro qué se describe y cómo debería ser descrito” para que una plataforma como esta funcione.
Para Hogan, Wikidata es la colección más grande de datos y conocimiento enciclopédico disponible de forma abierta en el mundo. Su principal aporte es centralizar información que luego puede reutilizarse en distintos artículos y versiones lingüísticas de Wikipedia.
“Por ejemplo, el hecho de que Osorio Vargas ganó este premio en 2016 está representado, de forma redundante, en muchos artículos de Wikipedia: el artículo sobre Osorio Vargas, el artículo sobre ese año de los Óscars, el artículo sobre el Óscar al mejor cortometraje animado, y puede quedar en otras tablas, listas, etc. Sin Wikidata, cada aparición de este hecho tiene que ser redactado, actualizado, etc., a mano por usuarios. Wikidata permite entonces centralizar los datos enciclopédicos en un lugar y luego reutilizar estos datos en distintos lugares de Wikipedia”, comenta.
Puedes conocer más sobre Wikidata aquí.
Ontología e inteligencia artificial: cómo representar y utilizar el conocimiento
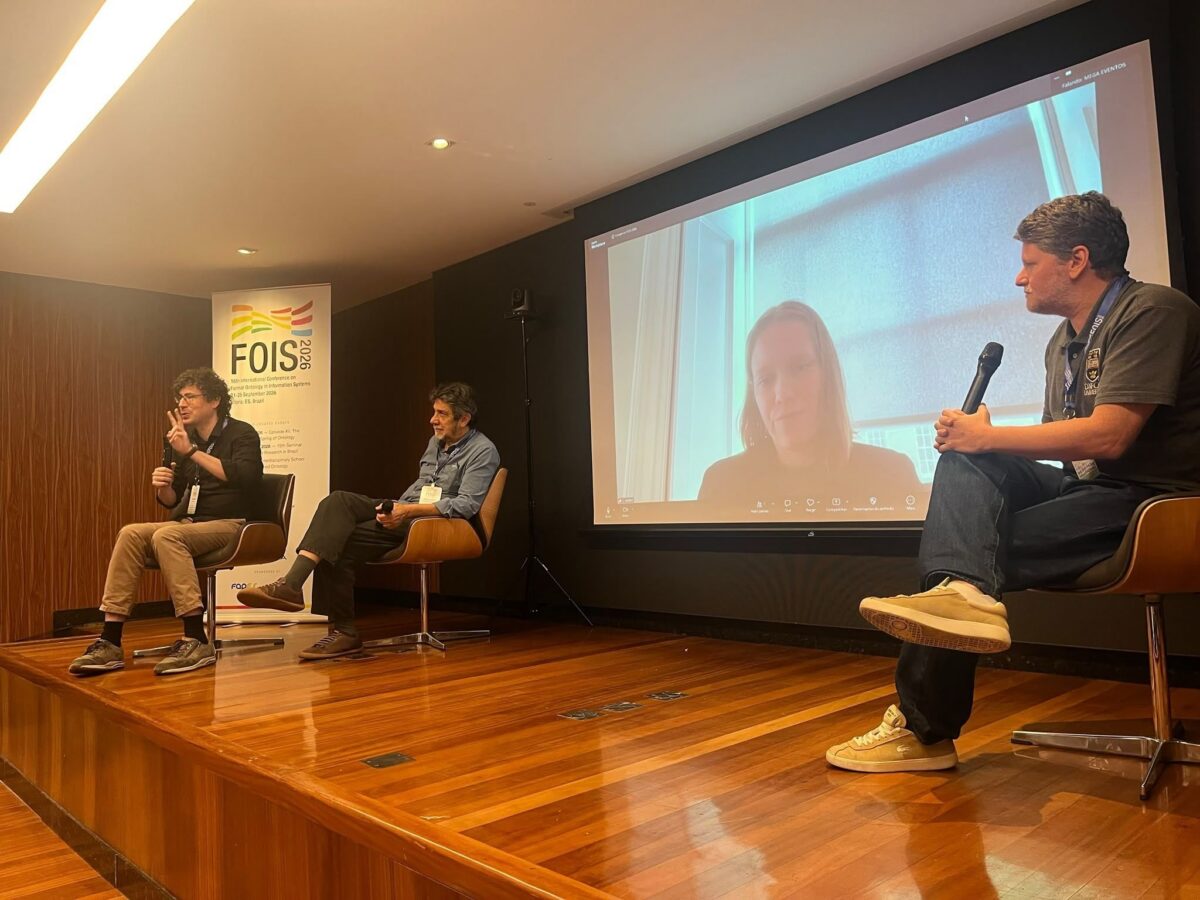
Además de la charla inaugural, Hogan integró el panel “Ontologies & Artificial Intelligence”, junto a otros keynote speakers de la conferencia. La discusión abordó cómo la ontología puede contribuir al diseño, evaluación y gobernanza de sistemas de inteligencia artificial, y cómo los avances recientes en IA están planteando nuevos desafíos para este campo.
“Cuando se habla hoy en día de inteligencia artificial, se habla principalmente de los avances rápidos en aprendizaje de máquinas. Pero la noción de ontología también surge de la inteligencia artificial simbólica, cuyo objetivo es definir e instruir a la máquina sobre cómo representar y utilizar el conocimiento del mundo”, explica Hogan.
El investigador señala que existe un interés creciente en combinar ontologías con la IA moderna. En este contexto, el panel discutió “cómo las ontologías pueden ayudar a mejorar plataformas de IA, y también qué puede pasar si las máquinas aprenden su propia ontología (ajena a nuestra ontología humana): sus propios conceptos, tipos de relaciones, o formas de modelar el mundo”, agrega.
La conversación también abordó los efectos sociales de la IA, la necesidad de no antropomorfizar estas tecnologías, los desafíos asociados a su concentración en pocas empresas y la exigencia de tener más control, explicación y transparencia. “En este último punto la ontología puede tener un rol clave”, finaliza Hogan.