El origen de dashAI, la plataforma de IA no-code de modelos de aprendizaje automático hecha en Chile
En conversación con el podcast FuturIA, el académico del Departamento de Ciencias de la Computación (DCC) y director de la Iniciativa de Datos e Inteligencia Artificial (IDIA) de la Universidad de Chile, también investigador del Instituto Milenio Fundamentos de los Datos (IMFD) y del Centro Nacional de Inteligencia Artificial (CENIA), Felipe Bravo, repasó el origen y desarrollo de dashAI, el software de código abierto que permite entrenar modelos de inteligencia artificial sin necesidad de programar, que opera íntegramente en el equipo de cada usuario y que ya supera las 31 mil descargas.
FuturIA es una publicación de análisis estratégico sobre inteligencia artificial dirigida a directivos, líderes y profesionales hispanohablantes, con audiencia en 79 países. En su capítulo N°98 del podcast homónimo, su autor, Sergio Vélez Maldonado —consultor y director del IQAI Institute—, conversó con Felipe Bravo, académico del Departamento de Ciencias de la Computación (DCC) y director de la Iniciativa de Datos e Inteligencia Artificial (IDIA) de la Facultad de Ciencias Físicas y Matemáticas (FCFM) de la Universidad de Chile, e investigador del Instituto Milenio Fundamentos de los Datos (IMFD) y del Centro Nacional de Inteligencia Artificial (CENIA).
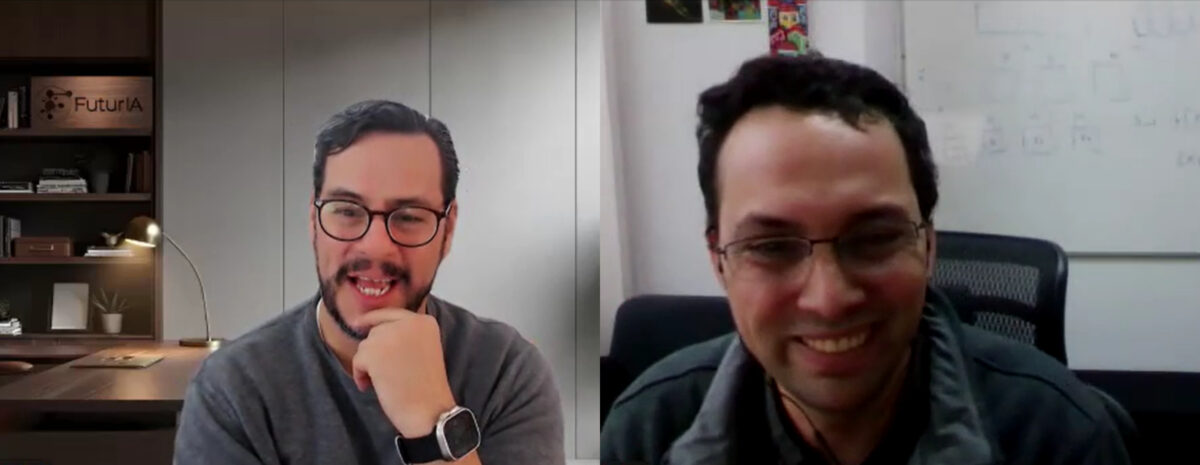
La conversación abordó la evolución del aprendizaje automático, la formación de talento avanzado en la región y las condiciones necesarias para construir soberanía tecnológica desde América Latina. Buena parte del diálogo, sin embargo, se concentró en un desarrollo concreto: dashAI, la plataforma de código abierto que permite entrenar y evaluar modelos de inteligencia artificial sin escribir código.
“La idea partió antes de ChatGPT y consistía en tener un software de código abierto con una interfaz gráfica intuitiva, o sea, no code, sin programar, que pudiese permitir a usuarios hacer todo el ciclo de vida de modelos de aprendizaje automático. Cargar datos, explorarlos, limpiarlos, entrenar modelos de clasificación, de regresión, de clasificación de imágenes, hacer predicción de fuga de clientes, etcétera”, explicó Felipe al momento de recordar los orígenes del proyecto.
“Eso partió porque llegaban muchos proyectos al Instituto Milenio Fundamentos de los Datos (IMFD) y al Centro Nacional de Inteligencia Artificial (CENIA) donde nos dábamos cuenta que la gente quería modelos de machine learning. Pero más que un modelo, ellos querían ser capacitados para entrenar sus propios modelos, porque a veces tenían datos (…) y para esta gente navegar entre PyTorch, scikit-learn, Pandas era un costo de capacitación muy alto. Entonces, ahí nos metimos a construir este software”, agregó.
Weka, el referente de dashAI
Mientras realizaba su doctorado en la Universidad de Waikato, en Nueva Zelanda, Felipe Bravo aprendió el funcionamiento de Weka (Waikato Environment for Knowledge Analysis), el primer software masivo de machine learning, libre y de código abierto, dedicado al aprendizaje automático y la minería de datos.
“Yo entendí muy bien la arquitectura de un software de esa complejidad: que fuera extensible, que se pudiera integrar a ciertas cosas, cómo abstraer ciertas cosas”, reveló el académico sobre Weka. Esa herramienta, explicó, quedó desfasada respecto de las tecnologías actuales, y de ahí surgió la idea de repensar el modelo con una interfaz web, extensible y compatible con las bibliotecas contemporáneas.
Para trabajar la usabilidad y la validación con usuarios, en 2022 al proyecto también se integró Claudia López, especialista en interacción humano-computador y también académica del Departamento de Ciencias de la Computación e investigadora de la Iniciativa de Datos e Inteligencia Artificial en la Facultad de Ciencias Físicas y Matemáticas de la Universidad de Chile, e investigadora CENIA.
dashAI: Un entorno local para datos sensibles
dashAI se instala como aplicación de escritorio en Windows, macOS y Linux, y organiza el trabajo en módulos. Permite cargar y explorar datos —archivos estructurados y multimedia comunes— y generar visualizaciones; entrenar y comparar modelos de clasificación, regresión o reconocimiento de imágenes; y acceder a modelos generativos de código abierto ejecutándose en la máquina del usuario. “La idea es tener distintos paradigmas de IA, la IA más clásica de machine learning junto con la IA generativa, en un solo ambiente“, resumió Bravo.
Esa arquitectura local es, según planteó en la entrevista, una de las razones del interés que ha despertado entre organizaciones que trabajan con información sensible: al no depender de servicios en la nube, los datos no salen del dispositivo. Al tratarse además de software de código abierto, cualquier institución puede desplegar su propia versión y adaptarla a sus necesidades.
Más de 20 tesistas y un método de desarrollo
El desarrollo de dashAI enfrentó una dificultad inicial de financiamiento. “La gente no entendía qué valor podía tener un software abierto y gratuito“, recordó Bravo al momento de recordar los inicios del proyecto. La respuesta fue diseñar un método que sumara el trabajo de titulación de los estudiantes: cada semestre se incorporaban cuatro o cinco integrantes que dedican un año al proyecto —el primer semestre a formular la idea, el segundo a desarrollarla—, con acompañamiento de ingenieros para validar los avances. Lo que funciona se integra a la plataforma; lo que no, queda como prototipo.
A diferencia de los proyectos de título que suelen agotarse en una aplicación aislada, el método permitió acumular trabajo en una misma base. A la fecha, más de 20 estudiantes se han titulado en el marco del proyecto. La iniciativa obtuvo posteriormente financiamiento del Fondo de Fomento al Desarrollo Científico y Tecnológico (FONDEF) de ANID, a través del instrumento IDeA I+D adjudicado en 2025, en la línea de bien público.
dashAI fue lanzada públicamente en 2026 y, según su sitio web, acumula cerca de 31.500 descargas. La plataforma está disponible en dash-ai.com.